
 MeshLine
Higiene de pipelines: eliminar fallos de sincronización para operaciones de ingresos fiables
Guía práctica para equipos de revenue ops: detectar, priorizar y automatizar fallos de sincronización. Reglas, ejemplos, rutas de excepción y plan de
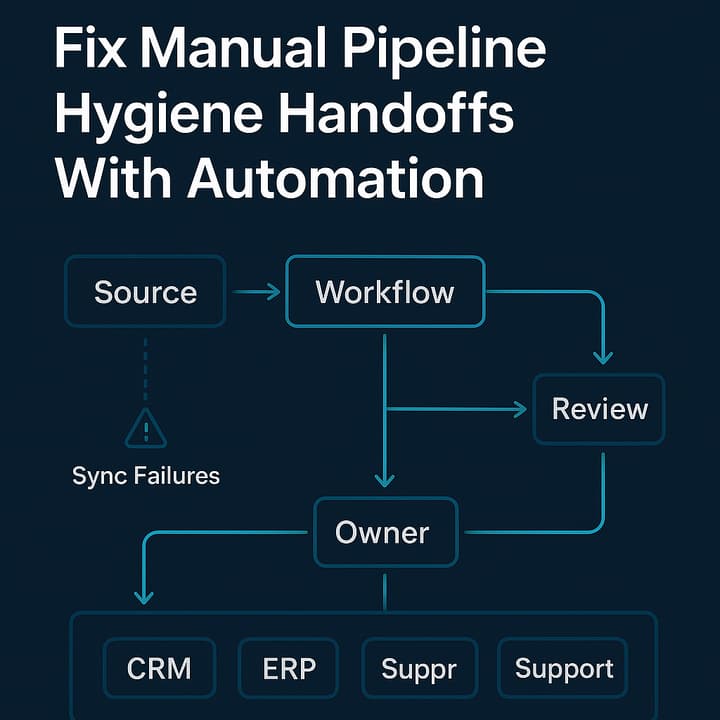

Los fallos de sincronización no son incidentes aislados: son síntomas de deuda de coordinación e infraestructura incompleta. Para equipos de revenue ops, cada sincronización fallida se traduce en pronósticos desviados, comisiones erradas y confianza perdida en los datos. Esta guía práctica te da un marco operativo, reglas inmediatas, ejemplos reales y un plan por fases para mover tu organización de apagar fuegos a mantener pipelines sanos y observables.
Por qué los fallos de sincronización son un problema de infraestructura
Cuando tratamos cada fallo como un ticket individual, generamos un patrón de parches: CSVs manuales, escaladas en Slack y fixes ad-hoc. Eso funciona a corto plazo pero suma deuda que aumenta el MTTR y reduce la trazabilidad.
Tres problemas estructurales aparecen siempre:
- Stack fragmentado: CRM, automatización, facturación, producto y análisis asumen inputs limpios. Un eslabón roto crea efectos en cascada.
- Coordinación manual: los atajos humanos son la banda adhesiva del sistema; impiden la observabilidad y amplifican la fragilidad.
- Falta de primitivas de infraestructura: retries durables, idempotencia, DLQs, validación de esquema y propiedad clara faltan en muchas integraciones.
Replantear fallos de sincronización como violaciones de contrato entre sistemas cambia la respuesta: de papelería a inversión en automatización durable.
Síntomas y causas comunes (qué debes buscar)
Síntomas observables:
- Etapas de oportunidad obsoletas y desviación del forecast.
- Comisiones sin conciliar o cálculos incorrectos.
- Registros duplicados o fragmentados entre sistemas.
- Segmentaciones erróneas y transiciones MQL/SQL inconsistentes.
- Dashboards con datos parciales o con lag.
Causas frecuentes:
- Deriva de esquema y cambios sin versionado.
- Retries de webhook agotadas o eventos descartados.
- Límite de API o throttling sin retropresión.
- Falta de idempotencia o lógica de deduplicación.
- Ambigüedad en propiedad y rutas de escalación.
Si ves cualquiera de estos síntomas, plantea la hipótesis de que un contrato entre sistemas fue violado y el tejido de ejecución no detectó ni remedió la violación automáticamente.
Marco operativo: contratos, observabilidad, propiedad y automatización
Adopta un marco con cuatro pilares para reducir la deuda de coordinación y mejorar el MTTR.
Contratos (qué debes definir)
- Integraciones contract-first: cada campo o evento inter-sistema debe tener un contrato versionado que defina esquema, significado y cardinalidad.
- Marca la fuente de la verdad: cada escritura debe llevar un token de procedencia y un cursor monotónico para que los consumidores entiendan orden y autoridad.
- Registro de contratos: un registro legible por máquina que documente propietarios, SLOs y vectores de prueba.
Observabilidad (cómo medir)
- Validación de esquema en los límites de ingestión y métricas centralizadas de aceptados/fallados.
- Métricas y logs para contar rechazos, crecimiento de DLQ y latencias.
- Pruebas sintéticas end-to-end en CI y ejecuciones nocturnas para atrapar regresiones.
Propiedad (quién hace qué)
- Owner del contrato: define semántica y prioridades del negocio.
- Owner de ejecución: responsable de instrumentación, runbooks y automatización.
- Owner de negocio: acepta el residual riesgo y prioriza esfuerzos.
Automatización (cómo remediar)
- Retries automatizados con backoff exponencial y límites explícitos.
- Idempotencia y llaves de deduplicación en escrituras inter-sistema.
- DLQs con umbrales accionables que disparen paging a propietarios, no solo alerts ruidosas.
Reglas rápidas para implementar hoy
1) No hay rollout sin contrato y tests: toda modificación en integraciones requiere versión de contrato y un harness de pruebas que inyecte casos de error.
2) Enforcear procedencia e idempotencia: cada evento que cruza sistemas debe llevar token de autoría y idempotency key.
3) DLQs con thresholds de paging: define umbrales claros que conviertan un acumulado en una llamada a los dueños, no en alertas genéricas.
4) Pruebas E2E en CI y programadas: las rutas críticas de revenue deben ejecutarse en pipelines automáticos para detectar regresiones antes de producción.
Casos prácticos y victorias rápidas (ejemplos reales)
Lead handoff: marketing -> CRM
- Síntoma: leads creados en marketing no aparecen en CRM.
- Solución rápida (días): habilitar DLQ persistente, validar payloads contra contrato y activar replay automático con notificación al owner.
- Resultado: menos importaciones manuales y menor tiempo de respuesta.
Quote-to-cash: CRM -> facturación
- Síntoma: deals closed-won en CRM sin factura en ERP.
- Solución rápida (1-2 semanas): idempotentizar la creación de facturas, añadir pruebas sandbox para el flujo de cerrado y versionar campos de precio.
- Resultado: menos fugas de ingreso y auditorías más limpias.
Backfills y data warehouse
- Síntoma: ETL falla en silencio y dashboards muestran huecos.
- Solución rápida: cargas incrementales con watermark, chequeos preflight y alertas por desviación de tasa de carga.
- Resultado: dashboards estables y menos sorpresas en el forecast.
Actualizaciones de suscripción: producto -> facturación
- Síntoma: cambios de plan en producto no se reflejan en billing.
- Solución rápida: colas durables, replay de eventos y transacciones compensatorias para actualizaciones perdidas.
- Resultado: menos disputas con clientes y conciliaciones más rápidas.
Decisiones operativas y rutas de excepción
Cuándo automatizar vs cuándo escalar a humano:
- Si la falla es no determinista y reintentos simples reducen la tasa de error por debajo del umbral SLO, automatiza el replay.
- Si el fallo implica cambio semántico (ej. nuevo campo de precio), bloquea el rollout y escala al owner del contrato.
- Umbrales de paging: definir N eventos en DLQ o X% de tráfico fallando durante T minutos provoca llamada con rotación establecida.
Rutas de excepción recomendadas:
- Excepción transitoria (throttle, latencia): retry automático con backoff y metrics para alertar.
- Excepción de esquema (nuevo campo, cambio de tipo): detener la pipeline, activar guard rails y convocar al owner de contrato.
- Excepción de negocio (duplicados, conflictos de autoridad): crear ticket automático con contexto y una runbook que especifique compensación.
Controles de calidad y criterios de aceptación
Criterios mínimos para considerar una integración crítica como 'sana':
- 100% de contratos críticos con validación automática.
- Pruebas sintéticas diarias para flujos prioritarios con retención de 90 días de resultados.
- DLQ con thresholds configurados que disparen paging a nombres concretos.
- Métricas SLO: tiempo medio de recuperación (MTTR) medible y objetivo de reducción trimestral.
Runbooks y QA:
- Cada contrato debe tener un runbook público que incluya causas probables, comandos de replay, y pasos de mitigación.
- QA debe incluir inyección de fallos: duplicados, payloads malformados y eventos fuera de orden.
Plan de implementación por fases (pragmático)
Fase 0 - Triage rápido (día 0-7)
- Inventario top 10 de contratos que impactan revenue.
- Añadir observabilidad ligera y logs detallados para esos caminos.
- Crear DLQs y thresholds iniciales; asignar owners temporales.
Fase 1 - Reducir incidentes repetidos (semanas 1-4)
- Implementar retries con backoff e idempotency.
- Agregar validación de esquema en productores y consumidores.
- Publicar runbooks para los 5 contratos principales.
Fase 2 - Endurecer la malla (semanas 4-12)
- Versionado de contratos y paths de deprecación.
- Herramientas de replay seguro, transacciones compensatorias y backfills.
- Integración con on-call y sistemas de incidentes; medir SLOs y MTTR.
Fase 3 - Eliminar la coordinación manual (continuo)
- Desplegar una capa de operaciones autónoma para aplicar contratos y automatizar reparaciones.
- Mover aprobaciones al engine y liberar a los humanos para decisiones de excepción.
Siguiente paso práctico y recursos
Inventaria hoy las 10 integraciones que más afectan a ingresos y habilita DLQs y pruebas sintéticas para esas rutas en 7 días. Si quieres validar opciones de implementación, agenda una demo en /products, revisa patrones adicionales en /products/organic-marketing-engine y en /products/revenue-intel-module, explora más guías en /blog o ponte en contacto en /contact para un workshop operativo.
Con la disciplina adecuada en contratos, observabilidad, propiedad y automatización, los fallos de sincronización dejan de ser un gasto operativo y se convierten en un motor de mejora continua para la higiene del pipeline.
Lecturas relacionadas
Para seguir el mismo tema desde otros ángulos operativos: